lunedì, aprile 10, 2006

Ingegneria del software: 19 maggio 2005

Management

Metriche di produttività

Linee di codice (poco indicativo: stessa soluzione usando + righe è peggio)
Albrecht: punti funzione (per stimare non posso usare il codice che non ho ancora, ma la progettazione!).

Somma pesata di:

  • Input/output del sistema
  • Interazione dell’utente
  • File usati internamente
  • ecc.

Banker: punti oggetto come somma pesata di:
  • Numero delle schermate da rapprentare
  • Numero di report da costruire
  • Numero di moduli 3GL da sviluppare

Halsted: Software Science
Sono dei metodi di misura alternativi al conto delle linee
Operandi: Una variabile o una costante
Operatore: un simbolo o una combinazione che influenza il valore di uno o più operandi
Indici quali (non ricordare!):Numero di operatori (E1) e operandi (E2) distinti
Numero di occorrenze di operatori (N1) e operandi (N2)
Numero di operandi concettuali in ingresso (F1) e uscita (F2)

Concetti:
Lunghezza: N = N1 + N2Stimatore di lunghezza: N’ = E1 log E1 + E2 log E2
Volume (grandezza fisica del programma) = N * log (E1 + E2)
Stimatore di difficoltà: E1 * N2 / (2 * E2)

In realtà è un metodo che lascia abbastanza il tempo che trova

McCabe (numero ciclomatico)Deriva dalla teoria dei grafi.
Vuole trovare una base per tutte le soluzioni possibili della visita del grafo dell’applicazione. Tante più sono le soluzioni che compongono questa base tanto più alta è la complessità dell’applicazione

Il numero ciclomatico è "e – n +2" dove e è il numero degli archi, n il numero dei nodi

ManagementPlanning obiettivi da raggiungere e risorse
Organizing decidere la struttura organizzativa, le responsabilità
Staffing reclutare e formare il personale
Controlling Controllo che il progetto vada come progettato

Planning
Stimare le forze
Stimare i tempi
Stimare i costi (variabile dipendente dalle prime 2)
I costi: personale tecnico, personale di supporto (segreterie, ecc.), risorse informatiche (hw e sw), materiale di consumo, struttura (affitto, bollette)

Fattori che influenzano i costi:
Numero di istruzioni da codificare
Capacità motivazioni, coordinamento del personale
Complessità dell’applicazione
Stabilità dei requisiti
Prestazioni e qualità richieste
Strumenti di sviluppo

Stime umane
Legge di Parkinson sul lavoro
Il costo dipende dalle risorse disponibile: il lavoro si espanderà fino ad occupare tutte le risorse disponibili

Price to win
Il costo è quanto più possibile il cliente è disposto a spendere
Molto usato.
Vantaggio: spesso si ottiene il lavoro (se gara)
Svantaggio: nessuna garanzia su ciò che verrà poi fatto
Non è male se posso rivedere i requisiti dopo aver preso il lavoro

Esperti esterni
E’ una prassi

Stima per analogia
Stima personale (per progetti passati) + fattori correttivi
E’ un metodo top-down

Dati d’azienda da raccogliere:
Produttività: LineeCodice/MeseUomo
Qualità: Errori/ LineeCodice
Costo unitario: CostoTotale/ LineeCodice

Oppure posso stimare sulla quantità di lavoro
Scompongo il progetto secondo una logica operativa (per fasi) e funzionale (per componenti)Quindi si stima il tempo per le singole fasi
Ancora bottom-up

Sistemi automatizzati:
Machine learning: Reti neurali, analogie, fuzzy logic
Boehm: simile a machine learning, ma si basa solo sul passato

Modello COCOMO

Tre modelli di formule
Base: dipende solo dalla stima delle linee di codice

Intermedio: 15 fattori correttivi legati a caratteristiche del progetto (legati al personale, alle macchine, legati al progetto), possibilità stima per componenti

Avanzato: non analizziamo

domenica, aprile 09, 2006

Ingegneria del software: 16 maggio 2005

Testing delle interfacce

Quali interfacce (grafiche? a linea di comando? A condivisione di memoria? A passaggio di messaggi?)
Tipi d'errore
Sbaglio nell'uso dell'interfaccia
Fraintendimenti dell'interfaccia
Errori di tempistica o di sincronizzazione
Quali sottoinsiemi del dominio di ingresso verranno trattati allo stesso modo?
Definiamo Classi di equivalenza i "gruppi di input" che verranno trattati in maniera analoga nel programma, così possiamo scegliere solo un rappresentante per ogni classe anziché testare tutta la classe
Si cerca di individuare dati di test che possano rivelare eventuali errori (es. numero negativi o zero)
Nel caso un dato sia un valore specifico provare sia con una classe valida che una non valida (es. password)
Gli errori tendono ad annidarsi ai limiti del dominio (ad esempio per 0, l'ultimo elemento di un array, ecc.)

Category PartitionE' un modo di dividere in classi di equivalenza

  1. Analisi delle specifiche (individuare l'unità minima testabile e raggrupparle in categorie: ad esempio un parametro, lo stato di un particolare file (non presente, sola lettura, ecc.))

  2. Partizionare le categorie in "scelte" (ad esempio sul dato parametro provare casi accettabili, stringhe vuote, casi non accettabili come stringhe troppo lunghe; oppure sull'ambiente: file non valido, ecc.)

  3. Determinare eventuali vincoli fra le scelte (Fare tutte le combinazioni significative delle scelte dei test; trovare dei vincoli fra le scelte per limitare il numero di combinazioni. Ad es. un file non valido potrebbe invalidare tutte gli altri input)

  4. Scrivere test e documentazione (Cercare di generare automaticamente i test in base alle scelte e ai vincoli

Approccio combinatorio: al posto di scegliere tutte le possibili combinazioni tra i test (contanto i vincoli) potrei prenderne solo alcune a caso

Software inspection
E’ una tecnica manuale (fatta da persone)
Moderatore: coordina i meeting, sceglie i partecipanti, controlla i processi
Readers, testers: sono quelli che al meeting leggono ad alta voce il codice (interpretandolo), cercano i difetti
Autore: l’autore del codice, risponde ad eventuali dubbi

Indicativamente 5/6 personeFasi:
Pianificazione (moderatore pianifica e sceglie le persone),
overview (per fornire il background e assegnare i ruoli),
preparation (attività X la comprensione del codice da parte dei partecipanti),
inspection (attività centrale: la lettura del codice e individuazione degli errori),
rework (l’autore corregge gli errori).

L’ispezione Goal: trovare il maggior numero di difetti
Massimo 2 sessioni al giorno da massimo 2 ore (molto pesante).
Trovare i difetti, ma non correggerli (non servono 5 programmatori per correggere gli errori)
Il moderatore regola che non si perda tempo (potevi farlo così, potevi farlo cosà)
C’è una checklist di cose da controllare SEMPRE (aggiornate e modificate per l’azienda)
Incentivi sociali: non dare punizioni, se mai darle dopo questa fase.

Active Design Review (variazione da software inspection)
Scegliere revisori con adeguata esperienza
L’autore fa domande al revisore (checklist) (per evitare che i revisori siano passivi)
Ci sono dei tool di supporto (controlli banali: tipo formattazione, riferimenti (checklists, standard con esempi, aiuti alla comprensione del codice (reenginering, ecc.), annotazioni e comunicazioni, guida al processo e rinforzo)
Posso usarlo anche su programmi incompleti e non funzionanti
In realtà è un processo piuttosto rigoroso…

Limiti:
Test solo di singole parti del codice
Non incrementale (non posso riproporlo automaticamente ad una nuova versione del software)

Vantaggi di avere un gruppo di testing (che faccia solo testing)
Maggiore specializzazione
Conoscenza di tecniche/strumenti
Distacco dal codice (pensa a cose diverse da chi l’ha scritto)
Indipendenza dalla valutazione

Svantaggi:
Si perde la capacità di scrivere codice
Minore conoscenza dei requisiti
Possibile pressione psicologica negativa sul team di sviluppo
Difficile stabilire le responsabilità (di chi scrive e sbaglia o di chi testa e non trova?)
Better testing-worst quality (“tanto poi loro correggono…”)
Alternativa: rotazione del personale

Modelli statistici
Ci sono studi sulla presenza di errori a seconda di alcune metriche del codice (lunghezza dei moduli, numero di uscite dal modulo, ecc.) quindi posso tentare di predire la distribuzione degli errori (però è solo una cosa statistica)
In alcuni casi al posto di ultra-testare un modulo “pericoloso” lo si fa riscrivere…

sabato, aprile 08, 2006

Ingegneria del software: 12 maggio 2005

Copertura delle definizioni
Voglio trovare dei valori tali che per ogni definizione (assegnamento) di una variabile voglio che ci sia almeno un uso all'interno di un caso di test

Copertura degli usi
Come copertura delle definizioni, ma applicato a tutte le variabili in gioco /non solo una)
(include la copertura delle definizioni)

In ambiente object oriented
Nei linguaggi OO é leggermente diverso il testing: l'unità da testare non é più la procedura, ma la classe in quanto i metodi spesso dipendono dallo stato dell'oggetto.
Ereditarietà: i metodi già testati nella classe base vanno ritestati (anche se non ridefiniti) perché cambia il contesto (chiaro che posso sottoporre agli stessi test).
Classi astratte: non ha senso testarle (devo testare le ereditate)
Dynamic late binding: difficile capire quale metodo di quale classe sarà eseguito (un metodo chiamato su una classe o sulla sua base potrebbe essere diverso)

Testing di una classe
Le classi andrebbero testate atomicamente... Ma come risolvere i problemi delle relazioni fra classi?! Andrebbero create delle classi Stub (mock objects): delle classi fasulle di cui scriviamo un funzionamento base-base e di cui garantiamo il funzionamento per l'input che deve essere sottoposto dal test

Basandoci sullo State Diagram
Posso voler testare tutti gli stati
Posso voler testare tutti gli archi
Coprire tutte le coppie di archi in/out

Problemi:
Potrebbe mancare il diagramma degli stati (ci sono tool che fanno il reverse engineering, però non é "l'idea", ma la sua rappresentazione pratica che potrebbe essere sbagliata)

Cos'altro possiamo fare?!
Beebugging: Inserire apposta degli errori (funziona solo se il tester e il dev sono persone diverse) Quasi una gara tra tester e dev.
Analisi mutazionale: Creo dei programmi simili a quello che devo fare, ma con piccole differenze (errori), li faccio testare. Scopo dei tester trovare quello giusto! (MOLTO DISPENDIOSO). Operatori mutanti: E' una funzione che dato in ingresso il programma crea dei Mutanti.

Test funzionale (Black box)
Non c'é conoscenza del codice
I dati di test possono essere ricavati dalle specifiche (requisiti funzionali)
Permette di trovare errori non sintetizzabili con criteri strutturali (es: funzioni scorrette o mancanti, errori di interfaccia, errori di prestazioni)
Potrebbe anche essere l'unico approccio possibile, maanche avendo il codice ci vuole sempre

Ingegneria del software: 9 maggio 2005

Test strutturale: White Box
Copertura dei comandi
E' praticamente impossibile coprire il 100% del codice (ad esempio non verranno eseguite le parti che sollevano eccezioni per input scorretto)
Copertura delle decisioni
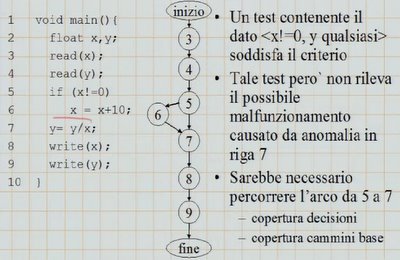
Certo é che in alcuni casi di input pur essendo coperti tutti i comandi potrebbe non essere coperto tutto "l'albero delle decisioni". Ad esempio: c'é un if con una condizione: ci entro e quindi ne copro il codice, ma se non ci fossi entrato la procedura poteva avere un comportamento diverso.

Per questo si parla di copertura delle decisioni
Una copertura totale delle decisioni prevede l'esecuzione di ogni arco del grafo di controllo del programma
La copertura dei comandi é un sottoinsieme della copertura delle decisioni

Copertura delle condizioni
Un test soddisfa il criterio di copertura delle condizioni se e solo ogni singola condizione che compare nelle decisioni del programma assume valore sia vero che falso per diversi casi t di T
La coperura delle decisioni non é un sovrainsieme di quella delle decisioni, pertanto il test perfetto le dovrebbe comprendere tutte e due

Copertura delle condizioni composte
Provare a rendere vere/false tutte le singole parti delle condizioni composte
Problema: il numero di casi da esaminare sta crescendo velocemente (esponenziale).

Condizioni Decisioni Modificate
Se io ho 2 condizioni in OR ad esempio non serve che io testi 4 casi, bastano:
falso falso, vero falso, falso vero
Il caso vero vero é già coperto dal secondo e dal terzo
Seguendo i casi in questa maniera la crescita dei test segue n+1 (lineare!)
Problema: "e i cicli?"
Potrei eseguirli 1 volta, 2 volte, fino ad infinito (ovviamente non applicabile)

N-copertura dei cicli
Posso decidere di coprirli N volte
ATTENZIONE coprirli N volte non vuole dire fare N loop nel ciclo, ma N!
Ovvero: entro ed esco dopo 1 ciclo, entro ed esco dopo 2, ecc. fino a N

Problema: come scegliere N?!

Precondizioni = Condizioni all'arrivo
Postcondizioni = Condizioni all'uscita del ciclo
Invarianti = Condizioni sempre valide

N=0 equivale ad un if con le precondizioni false
N=1 equivale ad avere un if con precondizioni vere
N=2 l'invariante e le condizioni di uscita implicano le postcondizioni (???)

N > 2 da questo punto di vista non mi dice più niente (anche se potrebbe essere significativo come qualsiasi altro valore)

Un altro criterio:
Contare il codice non a linee, ma a locchi (3 linee consecutive senza salti condizionali verranno sempre eseguite)
Contare anche il codice contenuto in funzioni? Anche se esterne?

Testing strutturale: analisi Data Flow (Analisi DF)
...non effettuato dinamicamente durante l'esecuzione
Si basa sull'analisi del codice senza eseguirlo (non soffre del problema di esplosione del numero di casi da analizzare)
esempio: puntatore non analizzato
Da qui arrivano la maggior parte degli errori di compilazione in linguaggi moderni (Java, C#)
Cerca da un analisi statica di prevedere possibili errori legati ai dati che si scateneranno in fase dinamica.

Analisi delle operazioni che possono essere effettuate sui dati:
Definizione: assegnamento di un valore ad una variabile
Uso: lettura del valore (p-uso: per condizioni, c-uso: nel calcolo di un valore)
Annullamento: se al termine di un'esecuzione il valore della variabile non é più significativo (appena dichiarata, quando esce dallo scope (potrebbe essere ancora puntata in C))

Così posso costruire delle espressioni regolari che rappresentano l'uso di una certa variabila ll'interno delle varie linee di codice
Es:

(1) void swap (*int x1, *int x2) {
(2) int x;
(3) x2=x;
(4) x2=x1;
(5) x1=x;
(6) }

La variabile x: auua (annullata in riga 2, usata in riga 3; usata in riga 5, annullata in riga 6
La variabile x1: aduda (annullata in 1, definita in 1; usata in 4, definita in 5, annullata in 6)
La variabile x2: addda (annullata in 1, definita in 1; definita in 3, definita in 4, annullata in 6)

Indizi di anomalie rilevabili:
x usata 2 volte senza essere definita
x1 viene definita una seconda volta senza mai essere usata
x2 viene definita 3 volte senza essere mai usata

Non sono errori sicuri ed in alcuni casi potrebbero essere comportamenti voluti (non uso io il valore di una variabile, ma imposto un registro hw, ecc. ecc.)
Alcuni linguaggi segnalano warning, altri segnano come errore (magari obbligando a fare in un altra maniera nel caso che il comportamento fosse voluto)

giovedì, aprile 06, 2006

Ingegneria del software: 5 maggio 2005

VERIFICA E CONVALIDA
Convalida
Confronto del software con le idee del committente
Verifica
Confronto del software con le specifiche formali. Le specifiche formali non sono (devono essere) ambigue.
(Verifica della corretteza del programma)

Sono punti di vista "volubili": é impossibile controllare tutto il software e l'utente ha sempre le idee poco chiare...
Quindi questo confronti vanno fatti durante tutto il ciclo di vita del software (non solo dopo la produzione)

I possibili problemi:
Malfunzionamento o guasto (failure)
Il programma da un risultato sbagliato (é un effetto esterno percepito dall'utente)
Es. Arian 5 (ESA 1996) viene lanciato e dopo 40 secondi esplode (percezione dell'utente)

Difetto o anomalia (fault)
E' legato al codice (non percepito dall'utente). Può originare un malfunzionamento
Può non manifestarmi come malfunzionamento se: (doppia anomalia: una elimina l'altra, si presenta su un input che non viene mai fornito)
Es. Il software di guida del satellite convertiva la velocità orizzontale da un double ad uno short e il programma é andato in overflow


Errore (error)
E' la causa di un anomalia
In genere si tratta di un errore umano (battitura, piuttosto che concettuale, padronanza del linguaggio, ecc.), ma può anche essere un bug nel compilatore
Es. Una parte di software era erditato dal lancio di Arian 4 in cui non succedeva mai che la velocità orizzontale soperasse i 16 bit signed (anzi c'era già un bel magine)

Considerazioni:
Non si era testato con la VERA traiettoria che il satellite doveva eseguire (tali dati non erano nemmeno stati forniti come specifiche)
Il meccanismo di protezione dalle eccezioni era focalizzato su errori HW e non SW

Tecniche di analisi del sw
Tecniche statiche (applicati al codice)
Metodi formali di correttezza

Analisi dataflow (analisi complessa dei dati e vedere come si incastrano tra loro)
Modelli statistici

Tecniche dinamiche (basate sull'esecuzione del programma)
Testing
Debugging

Principi
Sensitività: E' meglio fallire sempre che solo qualche volta (un bug che si manifesta solo in particolari condizioni é difficile da trovare)
Ridondanza: Rendere le intenzioni esplicite (usare più tecniche di convalida e verifica)
Partizionamento: Divide et impera (isolare il punto che da problemi)
Restrizione: semplificare il problema (es: usare un linguaggio fortemente tipizzato, evitare i puntatori, dichiarazione esplicita delle variabili, ecc.)

Feedback: regolazione del processo produttivo (non ripetere gli stessi errori)

Come evitare gli errori:
Prove formali: ricerca di anomalie (es. controllo delle specifiche formali)

Testing: rilevare malfunzionamenti. Tecnica ottimistica: faccio tante prove...
Debugging: Conoscendo un problema cerco l'anomalia che lo genera

DEF: Correttezza di un programma
P(d) indica l'esecuzione del programma su input d
Il programma é corretto solo se é corretto l'output di P(d) per ogni d che appartiene al dominio

Un test (T) é un sottoinsieme del dominio (D). Un elemento del test t é detto caso di test
Esecuzione del test: esecuzione del programma per tutti i t € T
Il programma passa (o supera) il test se il risultato per ogni t é corretto! Il test ha successo se viene rilevato un nuovo problema.

Criterio di selezione dei dati per il test:
Affidabilità: il criterio di scelta dei test é affidabile se per ogni t in T il passaggio del test implica che passerà per tutti gli altri t. Ovvero un elemento del test "controlla" l'altro: saputo il risultato per t so già quale deve essere il risultato per t1.
Validità: Qualora il programma non sia corretto esiste un test che ha successo (non passa)

Se un test é affidabile e valido e il test viene passato ciò implica che il programma sia corretto

Quando trovo un bug e lo correggo non posso garantire che il programma sia corretto... Oltre al fatto che potrebbero esserci altri errori, il cambiamento che ho effettuato ha alterato il programma così come era stato testato...

Selezione dei test: Approccio White Box
White Box prevede che ho accesso al codice sorgente e ne posso indagare la struttura
In genere gli errori si annidano nel codice che viene eseguito poco (negli angoli, come la polvere!).
Per questo sono nati i costrutti di gestione delle eccezioni!

Un caso di test si può considerare efficace quando:

- Esegue il comando che contiene l'errore
- L'esecuzione del comando che contiene l'errore deve portare ad uno stato scorretto
- L'output scorretto deve propagarsi fino all'uscita del codice in esame in modo da essere visibile

Il nostro test deve quindi coprire tutte le righe del programma

mercoledì, aprile 05, 2006

Ingegneria del software: 2 maggio 2005

Primi 10 minuti per chiarire le TBN (Time Basic Nets)
Altri 10 minuti a chiarire WTS e MWTS
Altri 10 minuti per un esercizio

Semantica forte (STS)
Una transizione DEVE scattare appena viene abilitata!
Molto più diffusa: sistemi deterministici
Se una transizione sta scattando il gettone con il timestamp più alto deve essere nel suo preset (nessun gettone può essere arrivato dopo!)
Una rete MWTS diventa a semantica forte se allo scatto di una transizione non c'é una transizione abilitata che ha un tempo di abilitazione maggiore.

Semantica mista (MTS)
Semantica forte o debole non é più definita nella rete, ma bensì sulla singola transizione.
In genere si mette una W dentro il rettangolo della transizione

E' possibile rappresentare il tempo come un qualunque altro dato di una rete ad alto livello?!
Definisco un dettaglio dei gettoni chronos, delle regole per lo scatto e delle
WTS Non ho problemi.
MWTS Problema: devo conoscere il timestamp dell'ultimo gettone della rete. Fattibile.
STS Possibile, ma dovrei mettere tutte le informazioni in un unico gettone (SCHIFEZZA!)

HLTPN (High Level Timed Petri Nets)
Uniscono le TBN alle High Level. Ereditano le regole temporali dalle TBN
Possibili interazioni: aspetti funzionali con aspetti temporali e viceversa
Problemi: un singolo scatto può generare infinite marcature (a seconda del tempo di scatto (ipotizzando che i tempi siano nei Reali))
Rappresentazione simbolica degli stati: (introduce imprecisioni)
Coppia di funzioni [m,C] ([mu, C]) dove m é la marcatura simbolica: associa degli identificatori simbolici ai posti e C sono delle equazioni che rappresentano le relazioni tra gli identificatori simbolici.
Sostanzialmente gli stati vengono raggruppati temporalmente

Ingegneria del software: 28 aprile 2005

T-invarianti
E' la stessa cosa dei P-invarianti...
Cs = 0
s deve essere una sequenza ammissibile
Reti P/T significa Posto/Transizione!

Reti di alto livello: si assegna un contenuto ad ogni gettone
Reti temporizzate: si assegnano dei valori di tempo ai gettoni (per sistemi real-time)
HLTPN Reti di Petri ad alto livello temporizzate: (ci lavora il prof. Bellettini) insieme delle 2 precedenti
Reti stocastiche: ragionano sul tempo medio

Modello temporizzato
Aggiungo un ritardo ai gettoni (appena metto il gettone devo aspettare un certo tempo per poterlo togliere). Diciamo che lo stato "ha un tempo".
Oppure un ritardo alle transizioni
Oppure faccio un sistema dinamico sulle transizioni con la possibilità di un ritardo variabile (averne più di uno, variabile a seconda dei gettoni in ingresso, avere un tempo relativo ai posti)

Time Basic Nets (TBN o TB)
Scelta di semplicità
Tempi sulle transizioni... (se avessi i tempi sui posti basterebbe splittare i posti e metterci una transizione con quel tempo in mezzo)
Mettendo il tempo sulle transizioni (ma anche sui posti) non é chiaro quale sia l'azione che si sta svolgendo. Posso allora sviluppare la rete aggiungendo un posto ed una transazione e mettendo su quest'ultima il tempo d'attesa. In tal caso la presenza di un gettone sul posto aggiunto mi indica che "sta scattando quella transizione"

Multiple firing time
Ovvero definire tempo minimo e massimo di scatto

Variable firing time

Il tempo di scatto é funzione del timestamp e del numero di gettoni (HTLPN) (posso definire anche gli estremi dei tempi di scatto)

Tempo di scatto assoluto vs relativo
Relativo: dipende sempre dall'istante/gettoni presenti (più semplice l'analisi); assoluto: può essere costante (scatt ad una certa ora)

Le TBN (Time Basic Nets) usano:
Tempo sulle transizioni
Tempi di scatto assoluti
Molteplici insiemi di tempi di scatto
Scelta dinamica del tempo di scatto (tra quelli dell'insieme)
Praticamente ogni gettone ha un suo timestamp ("data di nascita") pertanto non sono più tutti identici. In generale i gettoni portano con se delle informazioni che li differenziano (anche se potrebbero esserci 2 gettoni con le stesse informazioni e quindi indistinguibili)
Le transizioni hanno 2 funzioni dei tempi: tempo minimo per lo scatto e tempo massimo (deve scattare all'interno nell'intervallo fra i due tempi o non scattare più!), entrambe prendono come variabili i timestamp dei gettoni in ingresso. In più c'é il tempo di abilitazione: ovvero quando una transizione é abilitata: é un tempo maggiore uguale al gettone con timestamp più alto che userò (é detto enabling time)!
Il tempo di scatto di una transizione non potrà essere minore del tempo di abilitazione (se i gettoni necessari arrivano in t = X la transizione non potrascattare prima di X)

Semantica debole WTS (Weak Time Semantic)
Problema: potrebbe scattare una transizione che finisce prima di uno dei gettoni che sono presenti nella marcatura iniziale (ad esempio se qui sopra usassi la tupla di gettoni 3 e 4 e il gettone 5 fosse in realtà 20). Questo NON va bene!
Non é detto che una transizione scatti solo perché é abilitata (la fiamma del bruciatore dovrebbe partire dopo 3 secondi, ma se c'é vento potrebbe non partire!)
Posso costruire una semantica che forzi l'inizio di certe transizioni
Monotonicità rispetto alla marcatura iniziale
Ogni scatto deve finire in un tempo maggiore uguale a quello del "gettone più recente" che c'é nella marcatura iniziale.
Non posso avere inifiti scatti in un tempo finito! (attenzione agli scatti che impiegano tempo zero!)

Semantica Monotona Debole (MWTS)
Ha anche:
Monotonicità rispetto alla sequenza di scatto
Ovvero non possono scattare prima sequenze che vengono attivate da sequenze che scattano dopo (OVVIO) Posso avere scatti simultanei (in realtà lo sembrano se i miei quanti di tempo sono relativamente grandi)
La differenza non é piccola: l'analisi della rete non é più locale (devo controllare tutta la rete per capire quale transizione deve scattare prima)

Posso sempre costruire una sequenza MWTS per una WTS: basta permutare gli scatti (non é vero l'inverso).

MUST: guardare esercizio dal 23:00 della lezione del 2 maggio. Dura poco più di 5 minuti.

Ingegneria del software: 21 aprile 2005

Primi 10 minuti:
Non c'é modo di capire dall'albero se una rete é viva: esistono reti morte che possono avere lo stesso grafo di reti vive
Es.: Nel grafico dell'altra volta bastava aggiungere un arco da P3 a T4: potenzialmente si possono esaurire quindi i P3 quindi uno stato di (0;1;0) che é preso in considerazione nell'albero come (0;1;w), ma in realtà é un deadlock!

Alberi di raggiungibilità
Un albero che contempla tutte i possibili stati di tutti i posti nelle varie maracature possibili. Si può fare solo per le reti limitate!

Estensione: priorità
Svantaggio: si perde la località di decisione della abilitazione di una transizione

Rappresentazione matriciale
Devo assegnare un indice ad ogni posto ed un indice ad ogni transizione
Creo due matrici:
i (input)
Metto in ascissa le transizioni ed in ordinata i posti. Se esiste un arco tra posto e transizione nella corrisponde casella ne metto il peso (altrimenti 0)

o (output)
Metto in ascissa le transizioni ed in ordinata i posti. Se esiste un arco tra transizione e posto nella corrisponde casella ne metto il peso (altrimenti 0)
Il vettore m (marcatura)
E' un vettore colonna di dimensione P
Ovvero quanti gettoni ci sono nel posto con quello stesso indice
Se un vettore marcatura "copre" una colonna del vettore i allora può scattare la transazione corrispondente
Vettore Marcatura dopo scatto di transizione:
La nuova marcatura si otterrà da: Vettore m - vettore colonna della transazione in matrice i + vettore colonna della transazione corrispondente nella matrice o. In effetti conviene (informaticamente) calcolare già la matrice c come o-i (o perde di interesse).
Possiamo anche creare una matrice per una sequenza di scatti: sommo tutti i c delle transizioni coinvolte (o meglio moltiplico per un vettore riga che specifica il numero di volte che scatta ogni transizione).
Si chiamano reti pure le reti in cui preset e postset di ogni transizione non hanno intersezioni (agiscono su posti separati)

INVARIANTI
P-Invarianti
Relativi alla marcatura
Simile a trovare reti conservatice (o strettamente conservative)
Vettore h (pesi associati a dei posti) tale che moltiplicato per una qualsiasi marcatura raggiungibile M il prodotto h m deve essere costante
Quindi hm = hm1
m = m1 + Cs (s é una sequenza di scatti ammissibile)
hm = hm + hCs
hCs = 0
hC = 0
Devo trovare le soluzioni di questo sistema: di solito 0 o infinite. Se infinite voglio trovare le basi delle soluzioni (le soluzioni sono vettori, questi vettori possono combinarsi in infiniti modi: io voglio le basi linearmente indipendenti di tutte queste infinite soluzioni).
Che significato hanno queste soluzioni?! Queste soluzioni mi danno la configurazione di gettoni ... INSOMMA BOH! (é spiegato nell'ultima mezz'ora (anzi ultimi 10 minuti per l'interpretazione dei risultati)!)

Ingegneria del software: 14 aprile 2005

Consigliato seguire esercitazione primi 10 minuti
Possibili estensione delle reti di Petri
Fissare il numero massimo di token ammissibili in un posto.
Posso farlo senza bisogno di nuove regole: aggiungo un "posto complementare", lo collego alle transizioni del posto originale invertendo gli archi. Metto nel complementare tanti gettoni quanti sono i posti massimi meno il numero di gettoni che ci sono già nel posto ordinario.


Archi inibitori
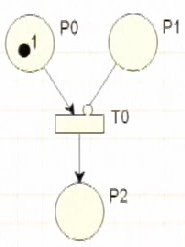
La transazione scatta se NON ci sono gettoni nel posto collegato con l'arco inibitore. (arco con pallino bianco)

Anche in questo caso posso ricondurre ad una rete di Petri standard (a patto che il numero di posti sia limitato). Basta che creo un P1 complementare con 1 gettone e collego questo P1 complementare con doppio arco a T0 (ci dovrà essere 1 gettone in P1Comp, ma potrà essercene al massimo 1 tra P1 e P1comp!).
Un esempio del problema di sincronizzazione lettori/scrittori con gli archi inibitori:


Tentare di togliere il peso degli archi:
Archi uscenti: posso introdurre un "posto globale" che ha una connessione a doppio senso con qualsiasi transizione eccetto che con la transizione interessata. Creo un posto ed una transizione "bis" e collego l'arco di ritorno al posto globale dalla transizione bis (figura). In tal caso l'unica transizione che potrà scattare dopo T0 e proprio T0bis!!!

Archi entranti:
E' molto più complesso... Il problema non é fare scattare con 2 gettoni, ma fare in modo che non scatti prima che ci siano 2 gettoni!!! Questo é un esempio (ma non automatizzabile con 3 o 4 o N gettoni!!!) (quindi ben venga il formalismo dei pesi degli archi)

Reti condizioni eventi (C/E)
Archi peso 1
Posti capacità 1
I posti si comportano da variabili booleane
Esiste sempre un'equivalente C/E di una rete P/T purché sia limitata: basta estenderla

Reti conservative
Una rete P/T con marcatura M si dice conservativa rispetto ad una funzione di pesi P se per ogni marcatura M1 raggiungibile da M la sommatoria di tutti i gettoni non varia!

Copribilità
Relazione tra marcature
M copre M1 se e solo se per ogni posto P il numero di gettoni é sempre maggiore-uguale in M1 che in M
M1 é copribile da M se esiste una marcatura (M2) raggiungibile da M che copre M1. Ovvero la copribilità non deve essere per forza diretta!
Definita M la marcatura minima (con il minimo numero di token) per attivare la transizione t allora t é morta solo se M non é raggiungibile dalla marcatura corrente
Se M copre M1 allora tutte le transizioni abilitate in M1 lo sono anche in M (più potrebbero esserlo delle altre!)

Albero di copertura
Ovvero ridurre una rete infita in un albero (e grafo) (quindi finito)!
...nel caso in cui abbia una marcatura che copre se stessa (si può ripresentare simile, ma con uno o più posti incrementati) posso mettere w (omega: significa infinito) nel posto della marcatura che viene incrementato...


Proprietà degli alberi di copertura:

  • Una rete di Petri é: limitata se w (omega) non compare in nessun nodo dell'albero di copertura
  • Una rete di Petri é: binaria se compaiono solo 0 e 1
  • Una transizione é morta (0-live) se non compare nell'albero di copertura
  • Condizione necessaria affinché una marcatura M sia raggiungibile é che esista un nodo etichettato con una marcatura che copre M
  • Non c'é modo di capire dall'albero se una rete é viva (dimostrato nei primi 10 minuti della lezione del 21 aprile: esistono reti morte che possono avere lo stesso grafo di reti vive (bastava aggiungere un arco da P3 a T4: potenzialmente si possono esaurire quindi i P3 (quindi uno stato di (0;1;0) che é preso in considerazione nell'albero come (0;1;w), ma in realtà é un deadlock!)

domenica, aprile 02, 2006

Ingegneria del software: 11 aprile 2005

Reti di Petri
In un certo senso evoluzione delle macchine a stati finiti, ma gli stati vengono visti come composizione di stati "atomici" e quindi le transizioni mutano solo parte dello stato.
http://www.daimi.au.dk/PetriNets

Hanno a disposizione una rappresentazione grafica intuitiva
Le unità delle reti di Petri sono:
Posti, Transizioni, Gettoni (e archi orientati). I gettoni vengono inseriti nei posti, gli archi connettono posti a transizioni (e vice versa). Un posto può essere attaccato ad una sola transizione, ma una transizione può essere attaccata a più posti.


Le reti di Petri sono la 5upla:
<P,T,F,W,m0>
dove:
P Insieme dei posti
T Insieme delle transizioni
F Relazioni di flusso (gli archi orientati)
W Funzione che associa un peso ad ogni flusso (non presente in tutte le versioni delle reti di Petri. Interi maggiori di zero)
m0 Numero iniziale di gettoni. Ogni posto ha dei gettoni (intero >= 0).

Pre(a) ovvero Preset(a) é un percorso predeterminato che porta al nodo a
Post(a) insieme dei nodi collegati con un flusso che partono da a
Comportamento dinamico
Si basa sull identificare quali sono le transizioni abilitate a scattare
Sono transizioni abilitate a scattare quelle il cui peso dei gettoni del posto é maggiore del peso dell'arco che congiunge con la transizione
La transizione t é abilitata nella marcatura M: M[t>
Lo scatto di una transizione t dalla marcatura M produce una nuova marcatura M'
Quando scatta una transizione per ogni posto in ingresso tolgo un numero di gettoni pari al peso dell'arco che conduce alla transizione e aggiungo il numero di gettoni pari agli archi in uscita che raggiungo posti che prima non erano presenti.

Nell'immagine: sulla sinistra un automa a stati finiti, sulla destra la corrispondente rete di Petri


Il peso degli archi non é specificato perché é banalmente 1

Alcuni dettagli: i gettoni NON si spostano vengono distrutti e ricreati.
Le reti di Petri sono NON-deterministiche (in alcuni casi più di una transizione potrebbe scattare e ne scatterà casualmente una delle tante che possono scattare.
Si consiglia di guardare 15 minuti di lezione dal minuto 20:00 della lezione corrispondente

Relazioni tra le transizioni (t1 e t2 nella marcatura M)
Sequenza (t1 e t2 sono in sequenza (nella marcatura M) se t1 é abilitato in M, t2 NON lo é, ma viene abilitato dallo scatto di t1 in M. In parole povere se t1 é attivabile e poi lo é t2)
Conflitto:
Strutturale: quando esiste un intersezione non vuota tra Pre(t1) e Pre(t2) ovvero quando hanno dei posti (precedenti) in comune.
Effettivo: se c'é un conflitto strutturale e il numero di gettoni nei posti comuni é sufficiente a fare scattare solo una qualsiasi delle transizioni, ma non entrambe (come strutturale, ma in più ci sono i gettoni)
Rilassata: t1 e t2 possono scattare in M, ma t1, t2 non é una sequenza ammissibile in M. Ovvero come l'effettivo, ma asimmetrico (potrebbe esserci un arco che permette l'attivazione in un senso)
Concorrenza: (quando non sono in conflitto)
Strutturale: quando l'intersezione fra i preset é nulla
Effettiva: Quando c'é intersezione fra i preset, ma ci sono abbastanza gettoni perché partano entrambe le transizioni (probabilmente in una transizione successiva ci sarà conflitto effettivo)

Insieme di raggiungibilità di una rete a partire da una certa marcatura M é il più piccolo insieme di marcature raggiungibili dalla marcatura M senza bisogno di aggiungere alcun token (il sistema si deve evolvere con i token già presenti nella marcatura M). Non é detto che sia identificabile (più che altro non é detto che sia finito).
Se la rete é limitata allora posso costruirne sempre un automa a stati finiti
Gradi di vitalità di una transizione
grado 0) la transizione é MORTA: se in qualunque caso é impossibile che dalla marcatura corrente verrà a scattare la transizione t in oggetto.
grado 1) Esiste almeno una marcatura raggiungibile in cui é abilitata
grado 2) Esiste almeno una sequenza ammissibile in cui posso fare scattare la transizione N (per qualsiasi N) volte
grado 3) Esiste una sequenza ammissibile in cui scatta infinite volte
grado 4) (é viva) in qualunque marcatura raggiungibile esiste una sequenza ammissibile in cui scatta.
Una rete si dice viva se tutte le sue marcature sono vive (tutte di grado 4).

Nell'esempio:
T0 é di grado 0, T1 di 1, T2 di 2, T3 di 3 e T4 di 4.
Perché T2 é di grado 2?
In effetti io posso fare scattare T3 N volte (quindi caricare P2 con N gettoni), ma poi faccio scattare T1 e non posso più tornare indietro (quindi un numero finito grande a piacere, ma non infinito!)!

Ingegneria del software: 8 aprile 2005

Programmazione orientata agli aspetti (by Monga)
L'ingegneria del software per risolvere un problema:
Scompone il problema in parti più piccole (analisi)
Ricompone la soluzione finale dalle soluzioni parziali (sintesi)

In realtà non in tutti i casi si può procedere così. Ad esempio se ci sono due parte che vengono eseguite in parallelo NON si può svilupparle in maniera completamente separata perché la parte di sincronizzazione fra le due deve essere pensata "insieme".

Spaghetti programmaing (codice intrecciato)
Code tangling
Un componente tenta di risolvere più problematiche

Code scattering
Il codice per la soluzione di un problema é diviso tra più componenti.

Es.
Nel mio codice inserisco ovunque delle printf di debug...
...nella singola procedura avrò del code tangling: anziché occuparsi di una cosa sola si occupa di 2 (anche il debugging)
...il componente "debug" invece é in code scattering: diffuso avunque nel codice e non concentrato in un singolo punto!

Miglioramenti linguistici hanno lenito la spaghetti programmaing (ad esempio l'introduzione delle istruzioni di ciclo hanno eliminato le difficoltà di seguire i goto
La programmazione orientata agli aspetti cerca soluzioni linguistiche per la semplificazione del codice

Costrutti speciali per isolare gli aspetti (aspects)
Costrutti per identificare i punti di integrazione (join points)
Aspetti vengono poi "intrecciati da un motore opportuno (weaving)
Il weaving potrebbe essere fatto dal compilatore,

AspectJ: é un Java orientato agli aspetti...
AspectSimpleTracing{
pointcut traced();
call (void Display.update()) (void Display.repaint(...));
before(): traced() {
println ("Entering: " + thisJoinPoint);
}
void println{//istruzioni per stampa sullo stream desiderato}
}
L'esempio qui sopra definisce un pointcut: i pointcut sono dei punti dove il compilatore di aspectJ inietterà chiamare al codice desiderato. In questo caso, tramite le istruzioni "before..." viene stabilito che prima delle chiamate a Display.update e Display.repaint viene chiamata la funzione println passando il joinpoint (oggetto con informazioni sul punto di join (immagino linea, stack trace)) corrente.
Non sono sicuro, ma credo che il pointcut rappresenti il joinpoint, mentre l'aspect é il fatto di dovere fare del tracing prima dei pointcut.

Potrei anche voler alterare dei parametri (ad esempio a repaint cambiare il colore)
In generale esiste un linguaggio per la definizione dei pointcut che permette di definire l'intercettazione di chiamate, origine delle chiamate, destinazione, argomenti, ecc.
Un altro esempio: potrei sincronizzare metodi che accedono ad un file: uso around (al posto di before) e con la parola chiave proceed chiamo il metodo.

Alcune considerazioni: non crea problemi di sicurezza (tipo ereditarietà), limite: é in fase di compilazione. Problema principale: difficile stabilire i punti in cui "si toccano" la programmazione classica e quella aspect oriented (difficile trovare i problemi)

HyperJ
Il software viene considerato un insieme di "concern units" (soluzioni atomiche a piccoli problemi).
HyperJ aiuta a comporre queste concern units.
Le concern units vengono composte in slices
Le slices vengono composte in hyperslices (slices composte da slices) e in hypermodules (l'equivalente delle classi)
...credo che praticamente si tratti di scrivere metodi e poi costruire le classi dichiarandole come composizione dei metodi scritti (potrei prendere uno slice e metterlo in più classi)!

venerdì, marzo 31, 2006

Ingegneria del software: 7 aprile 2005

Activity Diagram
Gli stati vengono chiamati attività

Le transizioni sono di solito etichettate con eventi (tutte tipo "quando finisce l'attività)
Le azioni di solito sono nelle attività
Le attività possono essere sia interne che esterne al sistema
Quando usare gli activity diagram:

  • Il flusso interno di un metodo (con eventuali indicazioni di (pseudo) concorrenza)
  • Il flusso di uno use-case (alternativo (o ortogonale) al sequence diagram)
  • La logica all'interno di un business process (caso principe)

Barre di sincronizzazione (fork/join):


Va specificato il punto finale dell'iterazione (punto cerchiato alla fine del grafico qui sopra)
Decisioni:


Piccolo rombo con due uscite etichettate con delle guardie (condizioni)
Non é un automatiscmo derivato da quanto successo prima, ma una vera e propria scelta (tipo scelta dell'utente)

Due attività possono essere connesse da un oggetto (un'attività modifica lo stato dell'oggetto che a sua volta fa partire un'altra attività)

Lo stesso oggetto può comparire può volte (tante quante sono i suoi stati)

Swim lane (corsie della piscina)
Si possono suddividere le attività per assegnargli un responsabile Da notare che in questo grafico possono comparire anche azioni esterne (il bibliotecario rimette il libro restituito sullo scaffale)
Assomiglia alle reti di Petri

User stories, scenari
Approccio con il cliente (cliente non tecnico)
Descrizione di come é lo scenario in pratica (cosa ci si aspetta dal programma)
Atomiche, semplici: descrivono una funzionalità alla volta
Il diagramma use-case descrive le user-stories
L'utente descrive "il sistema" l'architetto scinderà poi in varie parti (ed eventualmente modificherà/integrerà)
E' una vista sulla funzionalità, non sugli oggetti.
Attori: entità esterna al sistema, fonte o destinatario di informazioni (interagisce con il sistema). simboleggia un ruolo, più che una persona
In ogni use case ci deve essere almeno un attore (e vice versa). L'attore primario é il responsabile dell'avvio dello use-case
Esistono delle relazioni fra use-cases:
include (per esempio per fattorizzare funzionalità comuni e riutilizzarle)
extend (viene creato uno use case "virtuale" con dei punti devono essere specializzati (vengono marcati, ma non specificati, sarà lo use case che specializzerà a specificarli)
generalizzazione Uno use case eredita da un altro (scomparsa in UML 2). Generalizzazione dei ruoli: un ruolo potrebbe essere l'override di un altro ruolo.

Package diagram
Non é un vero diagramma
Mette insieme altri diagrammi
Si può mettere insieme (raggruppamento logico) class-diagram e use cases

Component Diagram
Suddivisione del sistema in moduli: File, librerie, eseguibili, tabelle, documenti
In genere un component é l'unità minima aggiornabile (ad esempio una DLL)


Necessario specificare eventuali interfacce implementate! Component2 si appoggia a Component1 per l'interfaccia indicata dalla freccia.

Deployment diagram
Permette di specificare la dislocazione fisica delle istanze dei componenti
Permette di specificare:
Nodi del sistema (le macchine fisiche)
Collegamenti tra i nodi (RMI, HTTP, ecc.)
Disposizione delle istanze dei componenti all'interno dei nodi e loro relazioni
Per evitare che diventi immenso si possono tagliere le informazioni sulle interfacce (già specificate nel component diagram)

martedì, marzo 28, 2006

Ingegneria del software: 4 aprile 2005

UML, DIAGRAMMI DINAMICI
Use Cases (agli effetti esterni)
Interaction Diagram (Sequence e Collaboration)
State Diagram (Dinamiche interne agli oggetti)
Activity Diagram (Possono essere usati per rappresentare flussi di decisioni)

Object Diagram
Ovvero come avvengono le interazioni tra gli oggetti
Ad esempio: oggetti di classe persona: studente e professore legati da esame sarebbero 2 quadrati collegati da una riga (e non 1 rettangolo con freccia ricorsiva)
E’ il diagramma delle classi visto a runtime

Sequence Diagram
Esprimono la dimensione temporale dell’interazione tra gli oggetti.
Sono orientati ai messaggi
Elementi: oggetti anonimi (posso non nominare alcuni oggetti che non devo richiamare), attori (entità esterne che devono interagire con il sistema stesso).
Lifeline: ovvero la linea di vita di ciascun elemento:

Due versioni:
Creare tutti i box all'inizio (1) o crearli quando viene creato effettivamente l'oggetto (2). La vita dell'oggetto é indicata da un box piccolo.


Messaggi come "istanze di associazione" (le classi devono avere un'associazione)
Sia sincroni (chiamate di funzioni) che asincroni.
Chiamata con un messaggio sincrono: freccia orizzontale (cfr 1.1), ritorno freccia tratteggiata aperta (sempre cfr 1.1)
Messaggio asincrono: mezza freccia (cfr 1.2)


Attributi dei messaggi
Numero gerarchico identificativo del messaggio (1, 1.1, 1.1.1, 1.2, 2, 2.1, 2.2)
Nome del messaggio
Condizione [tra quadre]
Iterazione *[tra quadre, preceduto da un asterisco] (condizione di ripetizione del messaggio: continua finché é vera)
Es.:
1 Fai quello [i<6] style="DISPLAY: block; MARGIN: 0px auto 10px; CURSOR: hand; TEXT-ALIGN: center" alt="" src="http://photos1.blogger.com/blogger/6463/2288/400/Messaggi2.jpg" border="0"> Alternative: Collaboration Diagram (che é una vista simile, ma più astratta), Activity Diagram (più orientato alla sincronizzazione tra attività parallele), State Diagram (associato ad una singola classe: come evolve agli stimoli che riceve dall'esterno (anche esterno del progetto))

Automi a stati finiti
E' una n-pla: <S,I,U, d, t, s0>
Dove:
S = Insieme finito non vuoto degli stati
I = Insieme finito dei possibili ingressi
U = Insieme finito delle possibili uscite
d = (delta) Funzione di transizione (indica i possibili passaggi da uno stato ad un altro in base ad un input € I) . Può essere una funzione parziale (non definita su tutto SxI): non é detto che si possa passare da ogni stato ad un altro. Può non essere una funzione vera a propria (a partire da uno stato con lo stesso input può portare a più stati, in tal caso si ha un automa NON deterministico).
t = La funzione di uscita (definisce le uscite). t: SxI -> U. Automi di Moore: le uscite dipendono solo dallo stato.
s0 = Lo stato iniziale (s0 € S)

State Diagram
Viene associato alla classe degli oggetti (comportamenti comuni a tutti gli oggetti di quella classe) Non viene fatto per tutte le classi
Vengono segnate le chiamate ad altri oggetti/classi.
Non vengono rappresentati tutti i metodi, ma solo quelli che modificano lo stato dell'oggetto. Es. (copie di libro):

Sarebbe bene segnalare le chiamate che portato uno stato in errore (freccia e stato con scritto "eccezione").
Si possono annotare anche le chiamate a metodi di altre classi/oggetti
Posso anche vedere (a livello di libro e non più di copie). Questo sarebbe un automa non deterministico se non avessi impostato delle guardie (indicazioni di quando un evento porta ad un ramo o ad un altro).
Esistono anche i Time-event: dopo un certo tempo se non sono avvenuti altri eventi avviene un altro evento. Oppure nel caso in cui l'oggetto subisca un evento (ad esempio il numero di copie diventa 0, indipendentemente dal fatto che le copie siano prestate, smarrite, distrutte).
Posso definire un superstato: uno stato formato da altri stati
In un superstato posso avere anche più di una macchina che viene eseguita contemporaneamente... In tal caso si ha che:
in caso di sospensione del superstato viene memorizzato il singolo stato di ogni macchina e poi ripreso
Il superstato termina quando terminano tutte le macchine contenute (si usa una barra di sincronizzazione.

Ingegneria del software: 31 marzo

Pattern
Pattern State
Creare una classe per gestire gli stati di un oggetto
Sostanzialmente: se c’è un oggetto che può avere vari stati deve avere una proprietà che indice lo stato che sia di un tipo astratto che viene poi ereditato da varie “classi stato”.
Una classe Context (contesto dell’oggetto) che implementa l’interfaccia State (una property per leggere/impostare lo stato). Bisogna decidere se è ConcreteState o Context ad impostare lo stato successivo.
La funzione sampleOperation viene ridefinita nei ConcreteState, tale funzione potrebbe ricevere il Context chiamante

Pattern LightWeight
Pattern per i passaggi si stato (da focus al passaggio di stato e non lo stato in se)

Pattern Composite
Gestire strutture ad albero di oggetti.
Il programma mette insieme oggetti complessi da oggetti semplici. Voglio che l’utente possa mettere insieme gli oggetti come vuole e li tratti tutti alla stessa maniera: sia che si tratti di un oggetto semplice, sia un oggetto aggregato m(di primo, secondo o ennesimo livello).
Nell’esempio: tutti gli oggetti sono picture e si sanno autodisegnare
Alternative: usare un interfaccia per il livello comune,
Fare gestire la composizione sull’oggetto composito (costruttore?) o sull’oggetto componente (ridefinire operatore?)
Property IsComposite: indica se un oggetto è composito
Altro esempio: soluzione di espressioni.

Pattern decorator (wrapper)
Può essere visto come un caso particolare di Composite:
Esempio: textbox può avere delle scrollbar (verticale, orizzontale, entrambe) o bordo (singolo, doppio, ecc.)…
Definisco la classe base VisualComponent da cui deriveranno tutte: TextView e Decorator. Decorator ha una proprietà component di tipo VisualComponent. Da Decorator deriveranno poi ScrollDecorator e BorderDecorator. La logica è di mettere un componente dentro l’altro (con nel punto più interno la TextBox e in quelli successivi dei decoratori).

Pattern Command
Componibile, separation
- Cos’è una callback (puntatore a funzione/evento: notifica le funzionalità da invocare in seguito ad un certo evento.
Sono l’equivalente OO delle callback con puntatori a funzione.
In sostanza: il client deve sollevare un evento. Le funzioni collegate all’evento devono essere “wrappate” in oggetti di tipo Command (astratto, interfaccia), Client contiene un oggetto Reciver (collezione di Command?). La classe astratta Command viene specializzata in differenti ConcreteCommand. I Command hanno un oggetto Invoker che avvia il metodo Execute (settando eventuali parametri prima)
Una possibile composizione di pattern: implementare Pattern Composite su Command (Multi Command).

Pattern FactoryMethod
Sopperisce al fatto che un costruttore possa creare sempre e solo lo stesso tipo di oggetti: può darsi che quale sia l’oggetto che servirà dipenderà dallo stato e non sono in grado di dirlo a priori.
In sostanza si definisce un metodo statico che fungerà da costruttore. Tale metodo contiene l’intelligenza per capire quale oggetto creare.
Lo schema si riferisce ad un’applicazione MDI.
Possibile estensione: FactoryMethod in Together

giovedì, marzo 09, 2006

Ingegneria del software: 21 marzo 2005

Modello dei dati
Come definire le classi per risolvere un certo problema.
Non é un procedimento completamente standardizzato, ma creativo.
Possiamo dividere in 3 tipi di classi:
Entity: definiscono il dominio applicativo (corrispondono ai dati che dobbiamo gestire)
Control: Definiscono il comportamento del nostro processo: la logica applicativa.
Boundary: Classi che gestiscono l'interfaccia con l'utente

Lo sviluppo dovrebbe partire dagli Entity Method per scegliere la disposizione in classi:
Estrazione dei nomi
Consiste nel cercare nelle specifiche (in linguaggio naturale) tutti i nomi, poi si sfoltisce
Si consiglia di usare l'inglese
A volte ci sono delle ridondanze che potrebbero essere generalizzazioni
Nomi generici: vanno chiariti meglio (tipo oggetto)
Nomi di eventi e operazioni facilmente non dovrebbero essere classi
Metalinguaggio (system, rules): ovviamente non va considerato come classe
Esterno al sistema: Nomi di oggetti che non interessano il programma (ad esempio giorno)
Attributi: Diventeranno attributi delle classi, non classi
Segue interessante esempio di analisi e studio di una gerarchia di classi (10:00 - 32:00 circa)
Si possono mettere dei constraint sulle relazioni UML: ad esempio: XOR, ecc.

Approccio per tipi di classi comuni
Si pensa ai tipi di oggetti:
    1. Concetti
    2. Cose reali
    3. Ruoli (oggetti esterni che interagiscono con il sistema, anche un'altro sistema lo é (ma anche una persona può coprire un ruolo)) e Persone (interessano per esempio per un'autenticazione)
    4. Eventi
    5. Organizzazioni
    6. Posti

    Collaboration Responsibility Card (CRC)
    Inventate per XP
    Scrivo un foglietto per ogni classe
    Si fa in presenza del cliente, quindi usare un linguaggio domain-oriented
    E' più utile per verificare le classi che per pianificarle

    Design Patterns
    Rende più facile riconoscere situazioni comuni
    I Pattern sono indicazioni per la risoluzione di problemi comuni
    Esiste un wiki interessantissimo sui pattern: http://c2.com/cgi/wiki?CodeSmells
    Anti-Pattern
    E’ la denuncia di soluzioni sbagliate in base alla propria esperienza.
    I Pattern sono una derivazione dell’architettura, il GOF (Gang Of Four) ha introdotto i pattern architetturali per l’informatica.
    Composizione di un pattern:

    • Nome (chiaro)
    • Contesto (quando e perché si presenta il problema che vorremmo risolvere)
    • Forze (perché il problema è difficile, scopi, vincoli e fattori motivanti)
    • Soluzione (di solito in diagrammi simil-UML)
    • Esempi (uno o più esempi di come si è affrontato il problema)
    • Contesto risultante (illustra i benefici del risultato proposto)
    • Razionale: motivazioni della bontà della soluzione
    • Pattern in relazione: ovvero pattern che posso incastrare comunemente con questo
    • Usi conosciuti: Altri contesti d’uso oltre agli esempi
    Meta pattern
    Aiuta a categorizzare i pattern
    Identifica due elementi base:
    1. Hook Method: punti dove si può incastrare un altro pattern. Punto in cui il pattern lascia carta bianca e si può iniettare qualcos’altro.
    2. Template Method: Metodo che coordina generalmente più Hook Method. Parte intoccabile del pattern, scheletro del pattern.
    Unification: Dove template e hook sono nella stessa classe
    Separation: Un metodo in una classe e uno in un’altra
    Connection e recursive connection: Contenuti in classi separate, ma tra loro associate (anche ricorsivamente)
    Nel libro del GOF hanno individuato 23 pattern, suddivisi in:


    • Creazionali: riguardanti la creazione di oggetti (es.: Singleton)Adapter, Bridge, Composite, Decorator, Facade, Flyweight, Proxy
    • Comportamentali: come devono interagire le classiChain of responsibility, Command, Interpreter, Iterator, Mediator, Memento, Observer, State, Strategy, Template Method, Visitor
    • Strutturali: composizione di classi ed oggettiAbstract Factory, Builder, Factory Method, Prototype, Singleton


    Pattern Singleton
    Implementare il concetto di oggetto separatamente da quello di classe (una sola istanza di una classe).
    In pratica si crea un costruttore privato e si mettere un metodo condiviso (Static(1)) che ritorna quell’unica istanza
    Osservazioni:
    Perché non fare una classe statica? Una classe statica o con tutti i membri statici non può essere ereditata. Inoltre potrei cambiare in futuro il numero di istanze disponibili.


    (1) I metodi statici sono “metodi di classe”: ovvero appartengono alla classe e non all’istanza: Sono richiamabili senza nessuna istanza e non possono contenere riferimenti a campi o metodi d’istanza. Metodi e membri statici sono condivisi a tutte le istanze (sono, appunto, legati alla classe)

    Ingegneria del software: 17 marzo 2005

    Object Orientation
    Programmazione modulare:
    Astrazione
    Incapsulamente (e information hiding)

    Esistono delle relazioni fra moduli:
    Una relazione fra moduli é un vettore che unisce una coppia di moduli (prodotto cartesiano sull'insieme degli oggetti)
    2 relazioni:
    USES:
    IS_COMPONENT_OF: l'opposto di USES (se A uses B, allora B is_component_of A)
    Una classe é definita da un contratto: garantisce delle funzionalità che vengono racchiuse al suo
    interno.

    Approcci ai moduli:
    Procedurale: raccolta di funzioni
    Data Pool: dati comuni (raccolta di variabili globali)

    Abstract Object: Vengono messe insieme le procedure ed i dati. Ad esempio: gestione dei files: il risultato della chiamata a funzioni varia a seconda dello stato dell'oggetto.
    Abstract Data Type: Viene definito un modello raggruppando le parti comuni a delle istanze per garantire all'utente (programmatore)
    Generic: Template parametrici rispetto al tipo di una loro parte (ad esempio: array)

    OBJECT ORIENTATION:
    Abstract Data Type: le classi
    Nuove relazioni:
    Ereditarietà (generalizzazione: un tipo deriva da un altro tipo e ne estende le funzionalità)
    Aggregazione: (IS_PART_OF)
    Nuovi concetti e principi:
    Polimorfismo: una classe può "spacciarsi per un altro tipo". 2 tipi di polimorfismo: di ereditarietà: un oggeto di tipo mela può essere "spacciato" per un oggetto di tipo frutta; di interfaccia: rondine e aereo possono essere spacciati per "IFlingObject"
    Dynamic Binding: In fase di esecuzione si sostituisce la corretta implementazione di un metodo per ogni oggetto.
    Ad esempio: se un metodo viene ridefinito si deciderà se chiamare quello "nuovo" o quello della classe base a seconda del tipo di oggetto su cui lo si chiama.
    Le classi:
    Sono il "progetto di costruzione" di un oggetto
    Possono essere un progetto "incompleto": (classi astratte) definiscono solo una parte di comportamento di un oggetto
    Le classi implementano una o più interfacce: contratti delle classi
    In UML il diagramma delle classi é la "vista statica"
    Definita in 3-4 parti:
    Nome della classe, attributi (campi), metodi ed eventualmente proprietà
    A sinistra posso porre: + (publico), - (privato), # internal (protected): disponibile solo per la classe e le sue derivate
    I metodi in corsivo sono quelli astratti. Se il nome della classe é in corsivo la classe é astratta.
    Cercare di fare sempre privato il più possibile

    Generalizzazione (ereditarietà):IS_LIKE_A, CAN_BE_A
    E' possibile definire una parte di oggetto.
    Classi derivate sono polimorfiche rispetto alle classi base (se quadrupede eredita da animale un
    oggetto di tipo quadrupede é anche istanza di animale)
    Permette riuso di codice (in generale le classi derivare dovrebbero estendere le funzionalità (e NON ridurle))
    Generalizzazione può essere anche multipla (una classe può ereditare da più di una classe base). Problema di ereditarietà multipla: (una classe potrebbe derivare 2 volte da un'altra (che implementazione dei metodi devo usare?)
    In UML la generalizzazione é rappresentata con una freccia con il triangolo bianco
    Non riscrivo i metodi ereditati a meno che non ne vada a cambiare l'implementazione (override)

    Relazioni tra classi in UML:
    Una riga collega le due classi.
    Una label sulla riga spiega l'interazione.
    All'attacco della riga viene specificata la molteplicità: può essere un numero o un range (1..* indica 1 o più)
    All'attacco della riga posso anche specificare il ruolo: ad esempio un'acquisto da persona a persona dovrà specificare quale dei 2 é nel ruolo di venditore e quale di acquirente.

    Se c'é una freccia APERTA (a V) indica che la classe da dove parte la freccia deve conoscere l'altra, ma non per forza il viceversa. Sostanzialmente la presenza della riga di congiunzione indica che la classe ha un attributo del tipo dell'altra classe
    Ovviamente si possono mettere più relazioni fra le stesse classi, o relazioni riflessive.
    E' sempre bene stabilire la direzione quando possibile

    Composizione
    Vuole dire che un oggetto fa strettamente parte di un altro oggetto (ad esempio un motore di un aereo)
    Gli oggetti "componenti" (motori) possono interagire verso l'esterno SOLO tramite l'oggetto composito
    (aereo), si indica con una linea iniziata da un rombo (dalla parte dell'oggetto composito)

    Per raggruppare più classi posso usare il package:

    Dipendenza
    E' una dipendeza non statica (non presuppone la conoscenza)... ???
    E' una relazione che non viene rimappata su un attributo/prorpietà di classe
    Poco usata
    Si esprime con una freccia tratteggiata terminata da una freccia a V


    Interfacce
    Sono delle classi astratte senza implementazione di alcun metodo. Possono venire implementate (multiple) anche dai linguaggi che non prevedono ereditarietà multipla.

    martedì, febbraio 28, 2006

    Ingegneria del software: 14 marzo 2005

    Processi "in the large" (ovvero scelta dei modelli)
    CMM: 1993, modello per autovalutare il processo software.
    Cinque livelli di processi:


    1. Nessun requisito: il valore dipende tutto dalle persone (niente linee guida, ecc.)
    2. Ripetibile: sottoponendo lo stesso problema viene risolto allo stesso modo o meglio. Definisco quali sono le fasi di un processo.
    3. Definito (ben definito): documentato, standardizzato a livello di azienda. Customizzabili a livello di progetto (ma customizzazione devono venire approvate).
    4. Gestito: Quantificabile ogni obiettivo che ci poniamo. Sono raccolte tutte le metriche necessarie a capire cosa sta succedendo.
    5. Ottimizzante: in continua ottimizzazione
    Ad ogni livello sono associate delle KPA (Key Public Area)
    Ogni KPA é coperta da: scopi, impegni, capacità, attività, metodi di monitoring della realizzazione, metodi di verifica della realizzazione

    Per essere di livello 2 (ripetibile):
    Gestione dei requirement
    Gestione del planning del software
    Capacità di fare delle misurazioni
    Gestione dei sottocontratti (cose appartate fuori)
    Tecniche di garanzia della qualità
    Software configurazion management

    Per essere di livello 3 (Definito):
    Organizzare il processo in maniera completa a livello di azienda
    Fare corsi di traning sul processo di sviluppo aziendale
    Sforzo di software engineering
    Politiche di coordinamento tra gruppi
    Tecniche di ispezione del codice

    Per essere di livello 4 (Gestito):
    Gestione della qualità del software
    Gestione delle quantità del software

    FOSS:


    1. Invenzione: avere l'idea del software
    2. Espansione e innovazione: uno o più compagnie si accorgono dell'idea e ci lavorano sopra (o gruppi opensource).
    3. Consolidamento: alcuni dei progetti iniziano a superare la selezione (gli altri falliscono o vengono assorbiti)
    4. Maturità: Le idee diventano complete, poco spazio per altri
    5. I team maturi diventano lenti e poco innovativi, i team FOSS (opensource) iniziano a erodere il mercato dei team commerciali.
    6. FOSS Era: alla fine rimangono solo i prodotti dei team FOSS, i prodotti commerciali diventano di nicchia (non si é ancora mai verificata).
    http://www.catb.org/~esr/writings/cathedral-bazaar

    OpenSource
    Come inizia:
    1. Parte dalla frenesia personale di uno sviluppatore.
    2. Inizia a coinvolgere altra gente
    3. Scambi di opinioni tra i programmatori
    4. Le persone disposte a spendere (tempo) su quel progetto danno il via al progetto
    Come continua:
    5. I membri del progetto lavorano al problema fino a produrre dei risultati presentabili.
    6. Si rende noto il prodotto
    7. Arrivano i primi suggerimenti esterni
    8. Interazione fra vecchi e nuovi elementi del gruppo
    9. Nuove informazioni vengono acquisite e si ritorna al lavorare sulle nuove idee (punto 5)

    E' un problema coordinare un progetto con molti programmatori.
    Confronto:


    ProprietarioOpenSource
    ModelloCattedraleBazaar
    RisorseDefiniteSconosciute
    PlanningIntero progettoStep by step
    UtentiUtente paganteCo-developers
    ObiettivoRispetto del contrattoRisolvere un problema
    MotivazioneStipendio (forte?)Voglia (debole?)
    Stato di progressoSegretoPubblico
    CollaborazioneFaccia a facciaInternet
    Assicurazione di qualitàManagementPeer review


    Problemi dell'opernsource:


    • Poca visibilità (finché un progetto non sfonda...)
    • Concorrenza all'interno del progetto: i programmatori hanno idee e/o priorità diverse (il progetto potrebbe spaccarsi)
    • Lavori sporchi: ci sono parti che nessuno vuole fare...
    • Passaggio delle consegne: Se il capoprogetto se ne vuole andare deve avere il coraggio di cedere il testimone.
    Strumenti per l'OpenSource:


    • Comunicazione:
      Internet (comunicazione a senso unico: tu publichi, gli altri leggono)
      Forum (mantenere una comunity e rispondere alle domande)
    • Sincronizzazione del lavoro e versioning:
      Sul codice (Source Code Management)Sulla documentazione (es. = wiki)
    • Automatizzazione delle build (Build Tools):
    • Bug tracking
    Source Code Management
    Programmi: CVS, SubVersion (http://subversion.tigris.com/), Bitkeeper (commerciale, ma usato per Kernel Linux), GNU arch, Monotone
    Archivia le varie versioni e gestisce la concorrenza nello sviluppo. "Magazzini di codice"
    Check out: estrazione dal repositori di un file
    Check in: archiviazione delle modifiche
    Caratteristiche comuni:
    Versioning dei sorgenti (possibilità di storicizzare versioni del codice)
    Gestione della concorrenza
    Tagging delle versioni (per lasciare appunti sulle modifiche ad esempio)
    Branch: Lo sviluppo può proseguire su più alberi (potrebbe esserci un ramo che non viene più sviluppato e si riprende da una versione precedente)
    I salvataggi sono differenziali (solo differenze rispetto alla versione precedente)
    Locking esplicito: permetto la modifica solo 1 persona alla volta
    Locking implicito: controllo solo al momento del check-in (al massimo ci sarà un sistema manuale (ma guidato) per gestire la sovrapposizione delle modifiche.

    Build Tools
    make (permette di definire regole di dipendenze per la compilazione e permette di invocare programmi esterni)
    ant (apposta per java). Si integra con CVS, JUnit (Framework per unit testing in Java) e permette di stabilire regole di validazione per permettere l'archiviazione (ad esempio no check in che non vengono passati i test JUnit). Molto flessibile ed espandibile

    Bug Tracking System
    BugZilla, Scarab, GNATS, BugManager
    Generalmente via web: permettono di archiviare segnalazioni, bug e gestione degli incarichi di risoluzione dei bug.
    1) Segnalazione (anche da anonimi)
    2) Definizione bug (se é un bug viene riconosciuto)
    3) Presa responsabilità: una persona si prende l'incarico di risolverlo
    4) Risoluzione

    Open Source su internet:
    http://sourceforge.net
    CVS, bugtracking, forum

    http://www.gotdotnet.org/Workspaces
    Per Microsoft.NET

    http://www.tigris.org
    Specifico per software engineering (ci sono subversion ed altri). Buona qualità, ma tanti requisiti.

    lunedì, febbraio 27, 2006

    Ingegneria del software: 10 marzo 2005

    Metodologie Agili
    Extreme Programming
    Kent Beck: Programmazione estrema: introduzione
    Molto materiale, molto di moda.
    http://www.extremeprogramming.org
    ftp://ftp.xprogramming.com/ftp/xpinstall.pdf
    http://www.hxp.it
    Le variabili in gioco:
    portata: la quantità di funzionalità che si vogliono implementare (delicata: mutevole)
    tempo: che si intende dedicare al progetto
    qualità: qualità più importanti
    costo: quanto sei disposto a spendere
    Solitamente si permette al cliente di fissarne al massimo 2:
    Qualità dovrebbe essere fisata al massimo
    XP vorrebbe mantenere come variabile libera la portata (prezzo fisso le funzionalità variano)
    Valori: (sono la linea guida)
    Coraggio
    Comunicazione
    Rapidità
    Semplicità
    Principi:
    Feedback rapido (comunicazione basata sul codice, comunicazione importantissima)
    Semplicità: non pianificare per il futuro, per il riuso
    Modifica incrementale: sviluppare piccole e semplici funzionalità un po' alla volta
    Accettare il cambiamento: essere sempre pronti a stravolgere tutto
    Lavoro di qualità: fare trovare bene il programmatore. Se si vuole che il programmatore renda deve essere soddisfatto di ciò che fa. Abbassare il turnover (fare rimanere i programmatori).
    Le figure:
    Manager o cliente (cliente interno o esterno): ha la responsabilità di decidere la portata, le pirorità tra le funzionalità e le date (ma le tempistiche le decide il tecnico).
    Tecnico: Stime dei tempi per le funzionalità, scelte tecnologiche, processo,pianificazione dettagliata (decidere all'interno della pianificazione grossolona quali sono le priorità).
    Coach: Guida e coordinamento dei programmatori: é il designer dell'applicazione
    Tracker: monitora il progetto e rende publiche le misure relative al progetto.
    Diritti del manager:
    Vedere i progressi del progetto
    Vedere cosa può essere fatto e in che tempi
    Cambiare idea (sostituire o modificare funzionalità)
    Diritti degli sviluppatori:
    Sapere cosa é necessario e che priorità ha. Non dovrà essere formale, ma dovrà essere chiaro.
    Fissare il tempo per l'implementazione
    Cambiare le stime in base all'esperienza
    Fissare le parti critiche (sottolineare quali sono le parti critiche: vitali, difficili da capire, difficili da stimare, ecc. ecc.)
    Produrre software in pace.
    L'approccio:

    • Planning game (discussione con il cliente su quali saranno le prossime funzionalità, ecc.)
      Esplorazione delle funzionalità utili. Vengono scritte su foglietti.
      Impegno: Ognuno dice la sua sui vari foglietti e viene deciso a chi assegnarli
      Gestione: direzione dello sviluppo con correzioni dall'andamento reale. Il tracker qui svuota il suo sacco.
    • Brevi cicli di rilascio riduco il rischio di sbagliare le stime. In contrasto con l'"avere rilasci significativi". Indicativamente massimo 1 o 2 mesi
    • Uso di metafore é un po' il design informale del progetto. Quadro d'unione del progetto. Difficile trovare la metafora, deve essere condivisa con l'utente.
    • Semplicità del progetto NESSUNA DUPLICAZIONE di codice
    • Testing testare, testare, testare. Testing del codice: prima scrivere i test, poi scrivere le funzionalità (da fiducia nel codice al programmatore); testing funzionalità: il cliente scrive (in linguaggio comune) i test da effettuare (da fiducia nel programma al cliente).
    • Refactoring: Scrivere il codice nella maniera più semplice, più pulito. Posso sistemare anche parti di codice funzionante. Migliora la qualità per i colleghi. Vitale: elimina l'entropia. Continuo e graduale.
    • Programmazione a coppie (pair programming) Aiuta a rispettare i principi di XP, a diversi ruoli, aiuta l'integrazione di nuovo personale. Le coppie variano frequentemente. I programmatori devono accettare XP.
    • Proprietà collettiva: Tutti devono sapere tutto. Il codice é di tutti, tutti devono tenerci al codice.
    • Integrazione continua: ovvero riunire tutte le modifiche, fare delle build (sulla macchina comune)!
    • Settimana di 40 ore: Inutile stressarsi: quando si é sotto stress si produce brutto codice. Fare stare bene il programmatore. Piuttosto rifare la pianificazione.
    • Cliente sul posto: parlare tanto con il cliente. Un rappresentante del cliente dev essere sempre sul posto. Permette di fare le specifiche leggere all'inizio. Diciamo che deve essere sempre disponibile (non per forza dagli sviluppatori).
    • Standard di codifica. La facilita la comunicazione (la comunicazione é sempre attraverso il codice).

    Riassumendo:
    Requisiti: leggeri, mediante le user stories (l'utente scrive cosa si aspetta dal programma)
    Design: basato su una metafora e su CRC (class responsibilities collaborations)
    Codice: Programmazione a coppie, proprietà collettiva, integrazione continua, standard di codifica
    Test: del codice (del dev), funzionale (del cliente)
    Documentazione: la documentazione sta nel codice (talmente chiaro da essere capito e ben testato: i test sono i casi funzionali) e nell'utente che ha seguito il progetto.
    Tools per i test: JUnit, NUnit, xUnit
    Quando NON usare XP:
    Se devo rinunciare anche ad una sola delle pratiche
    Impossibilità di avere feedback veloci (ad esempio un'applicazione che impiega 2 giorni a girare)
    Team troppo numerosi (idealmente 10)
    Necessità di documentazione basata su certificazione
    H6: Ipotesi di Beck e Fowler: L'uso di metodologia agili riduce l'impatto della richiesta di modifiche
    Quando usare XP:
    Cliente indeciso
    Lavori non enormi
    Disponibilità del cliente


    Consultare bene questo (riassunto delle fasi):